De agent development lifecycle
AI

Roy Steunebrink
11 / 11 / 2026
5 minuten
Een agent werkend krijgen lukt inmiddels bijna iedereen. Maar de teams en organisaties die voorop lopen in de AI revolutie doen iets anders. Zij leveren agents keer op keer op, veilig en voorspelbaar. Niet als losse experimenten, maar als een herhaalbaar proces.
LangChain CEO en founder Harrison Chase noemt dit proces de agent development lifecycle, kortweg ADLC (artikel). Nieuw is het idee niet. Het is een evolutie van de software development lifecycle (SDLC), die veel lezers zullen kennen. Maar eerlijk is eerlijk, in softwareontwikkelingen nemen we het met die cirkel niet altijd even nauw en vaak gaat dat goed. Een applicatie die vandaag werkt, doet morgen precies hetzelfde. Zolang niemand iets verandert, verandert er niets.
Bij agents gaat die vlieger niet op. Ook als je zelf niets aanpast, verandert er van alles om je agent heen. De modellen leverancier brengt een nieuwe versie uit, je productinformatie wordt bijgewerkt, klanten stellen vragen die niemand had voorzien. Het gedrag van de agent schuift ongemerkt mee. Een applicatie zonder onderhoud verouderd maar zal wel blijven werken. Een agent zonder onderhoud wordt steeds slechter.
Vier fases, één cyclus
De lifecycle bestaat uit vier fases: bouwen, testen, uitvoeren en monitoren. De volgorde is bewust gekozen, maar het belangrijkste element is dat het cyclisch is.
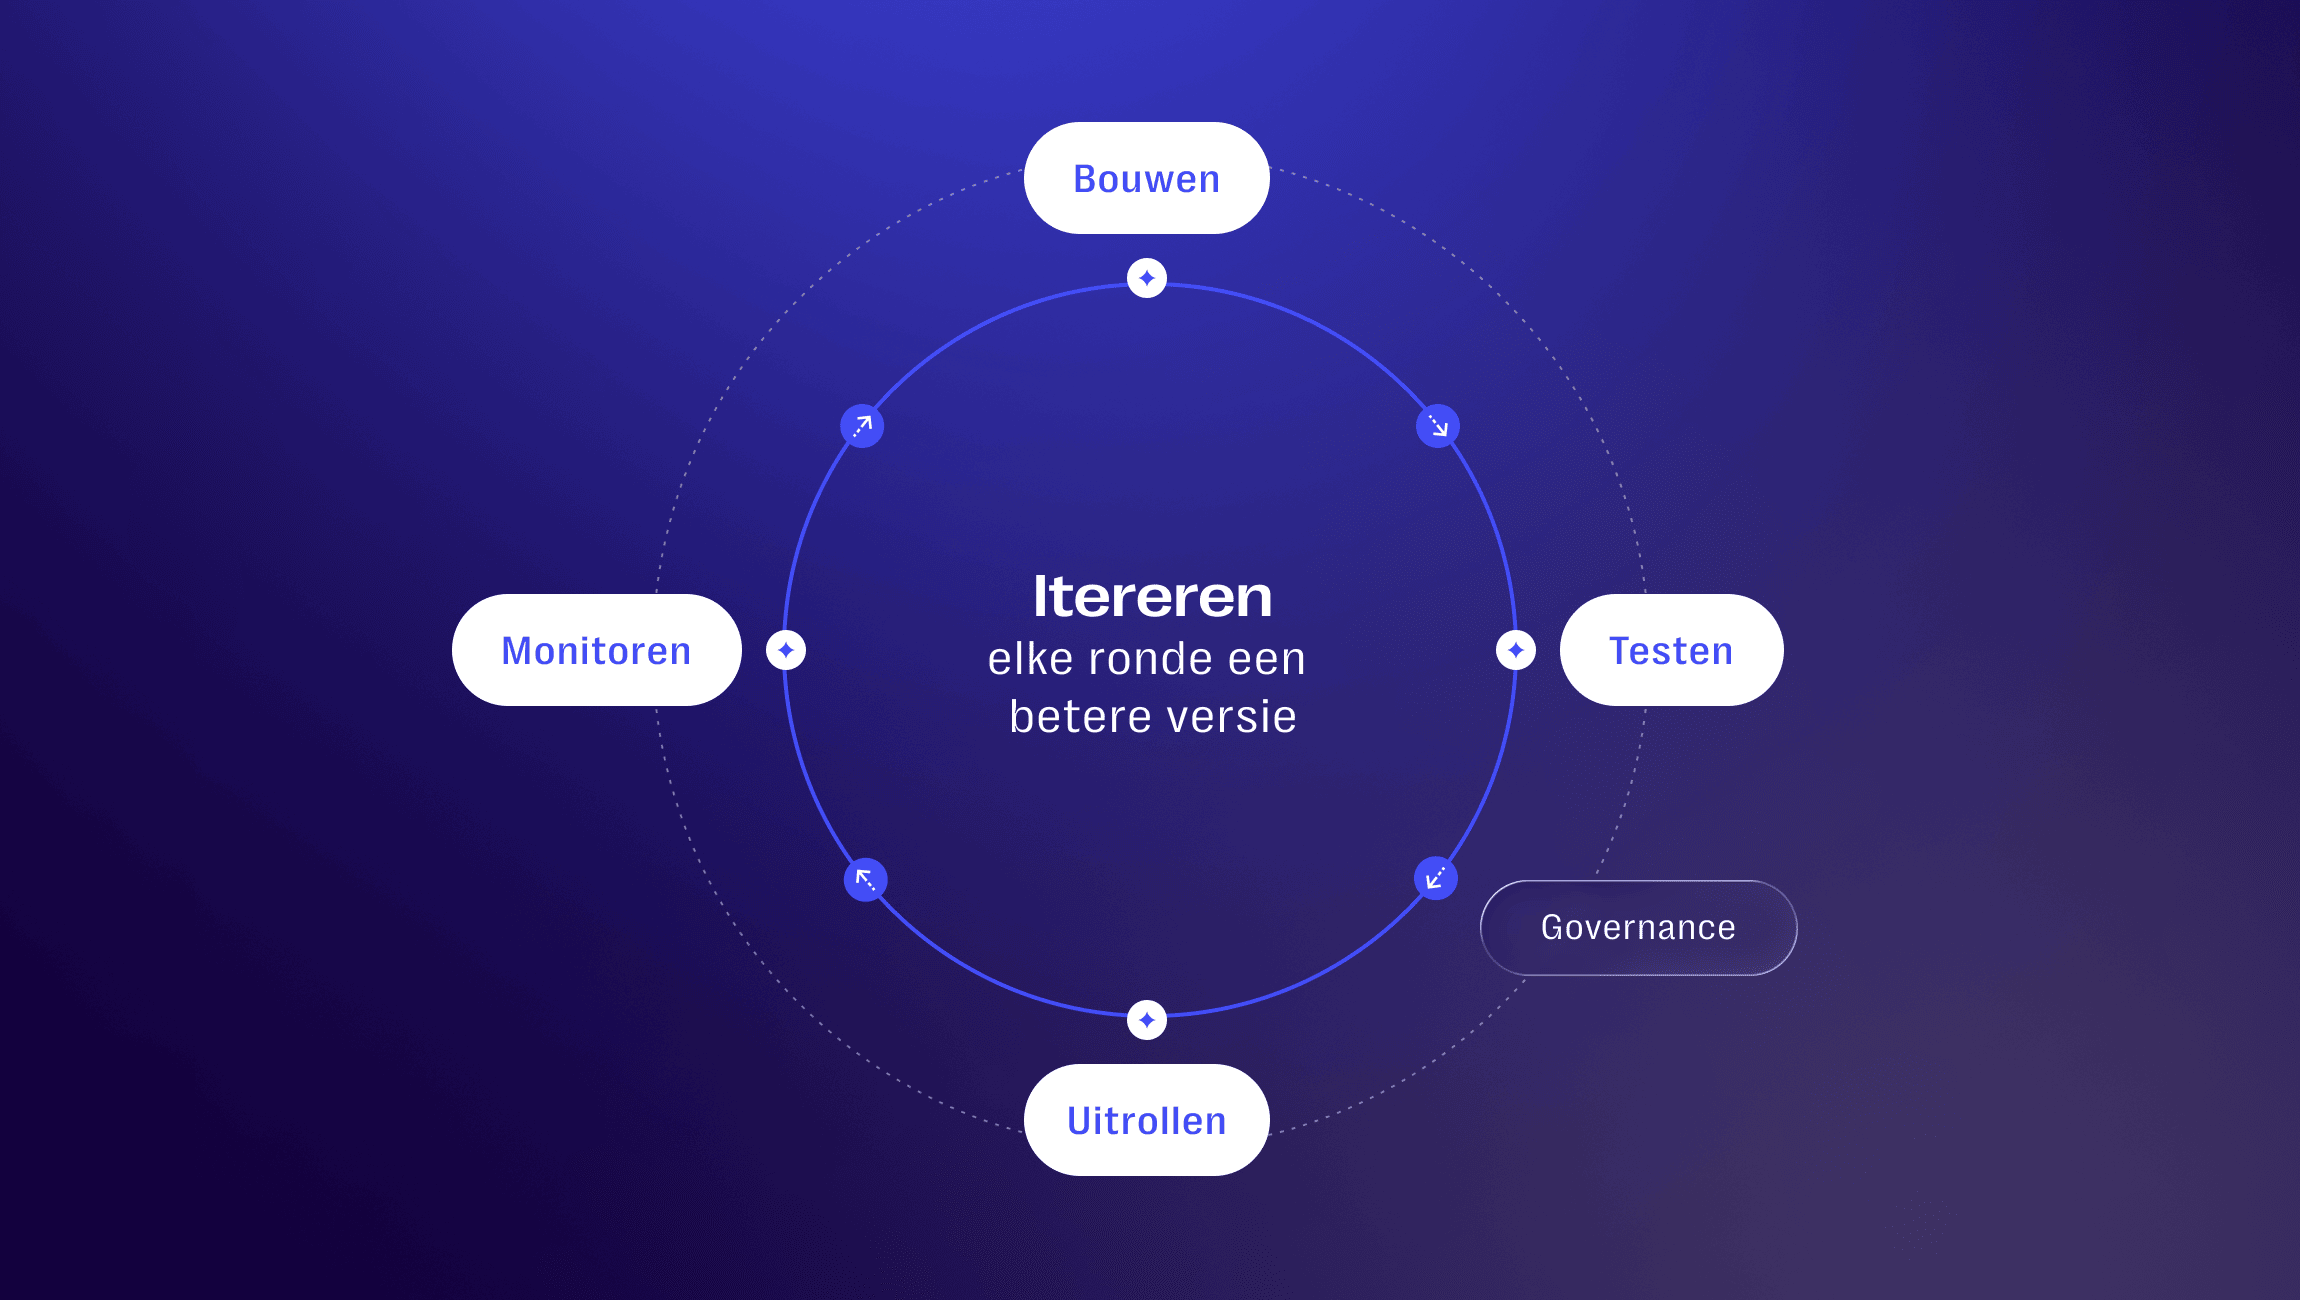
1. Bouwen
Hier bepaal je wat voor agent je maakt en hoe. Elke agent heeft een harnas, alleen verschilt wat erin zit. Bij een eenvoudige agent zijn dat vaak alleen een paar tools. Bij een serieuze agent komen daar instructies, skills, koppelingen met systemen en context bij. Elk onderdeel geeft meer grip op hoe de agent werkt, maar is ook iets om te onderhouden. De vraag is dus niet hoeveel je erin stopt, maar welke onderdelen van jou moeten zijn. Steeds vaker bouwen niet alleen developers mee, maar ook de mensen die de domeinkennis hebben.
2. Testen
Voordat een agent live gaat, wil je weten of de agent er klaar voor is. Dat doe je met evaluations: een vaste set voorbeeldtaken waarop je elke nieuwe versie toetst. Die set hoeft niet op dag één compleet te zijn. Zolang het maar laat zien of een wijziging de agent beter of slechter maakt, pas je niet meer blindelings aan. Voert een agent gesprekken, dan is één losse vraag toetsen niet genoeg. Problemen ontstaan soms pas bij de derde of vierde vraag, als de agent moet onthouden wat er eerder is gezegd. Daarom laat je een tweede AI de rol van klant spelen en een heel gesprek voeren, zodat je ziet hoe de agent zich van begin tot eind gedraagt. Elke fout die je zo vindt, gaat de testset in. Zo bouw je een vangnet op dat voorkomt dat dezelfde fout na een update terugkomt.
3. Uitrollen
Agents draaien vaak langer dan een gewone applicatie. Ze wachten op input, roepen tools aan en moeten verder kunnen waar ze blijven als er iets hapert. Daarvoor heb je een runtime nodig die voortgang vastlegt en momenten waarop de agent pauzeert voor een akkoord van een mens. Daarnaast voeren agents vaak zelf code uit, omdat daar veel waarde zit. Een rapport als PDF opmaken, een berekening maken of een bestand omzetten gebeurt allemaal met de code. Dat wil je mogelijk maken, maar wel veilig. Daarom werkt een agent in een sandbox: een afgeschermde omgeving waarin de agent vrij zijn gang kan gaan, zonder bij de rest van je systemen te komen.
4. Monitoren
Eenmaal live wil je zien wat een agent echt doet. Daar zijn traces voor: de volledige opname van elke stap. Bij gewone software lees je in de code hoe iets werkt. Bij een agent lees je dat in zijn traces, zij zijn de documentatie van het gedrag van de agent. Je kunt een gesprek teruglezen, visueel stap voor stap doorlopen en zien welke keuzes de agent maakt. Uit al die traces haal je vervolgens signalen, zoals een model dat beoordeelt of de vraag goed is beantwoord, of feedback van gebruikers zelf. Dashboards en alerts laten zien waar het schuurt.
Itereren
En dan begint het opnieuw. De lastigste gesprekken uit productie worden nieuwe testcases. Een fout die vaker terugkomt krijgt een eigen evaluator, zodat elke volgende versie daar automatisch op wordt getoetst. Wil je iets aanpassen, zoals een ander model, een nieuwe skill of scherpere instructie, dan doe je dat als experiment. Je draait de oude en de nieuwe versie op dezelfde testset en ziet zwart op wit wat de wijziging met het gedrag doet. Zo is elke versie aantoonbaar beter dan de vorige, of niet, en ga je door naar het volgende experiment.
Waarom dit geen gewone software ontwikkeling is
Bij gewone software weet je of iets werkt. De knop doet het of niet. Bij agents is dat minder zwart-wit. Een agent kan een technisch foutloos antwoord geven en niet doen wat er van hem gevraagd wordt. De agent kiest de verkeerde tool, gebruikt verouderde context of slaat een goedkeuring over. Op een dashboard met uptime en foutmeldingen zie je daar niets van terug.
Vaak is er ook niet één goed antwoord. Een samenvatting, een advies of de keuze om door te verwijzen kan op meerdere manieren goed zijn. Dan toets je niet op de uitkomst, maar op criteria. Was het antwoord onderbouwd, volgens de agent afsprakenstelde de agent een vervolgvraag waar dat nodig was?
Een groot deel van een agent is helemaal geen code. Instructies, skills en context veranderen vaker dan de applicatie zelf en worden het best beheerd door mensen die de domeinkennis hebben. Daarom horen die onderdelen een eigen plek te krijgen, een context hub met versiebeheer, zodat je het gedrag van een agent kunt bijsturen zonder hem opnieuw uit te rollen.
Drie routes, één vraag
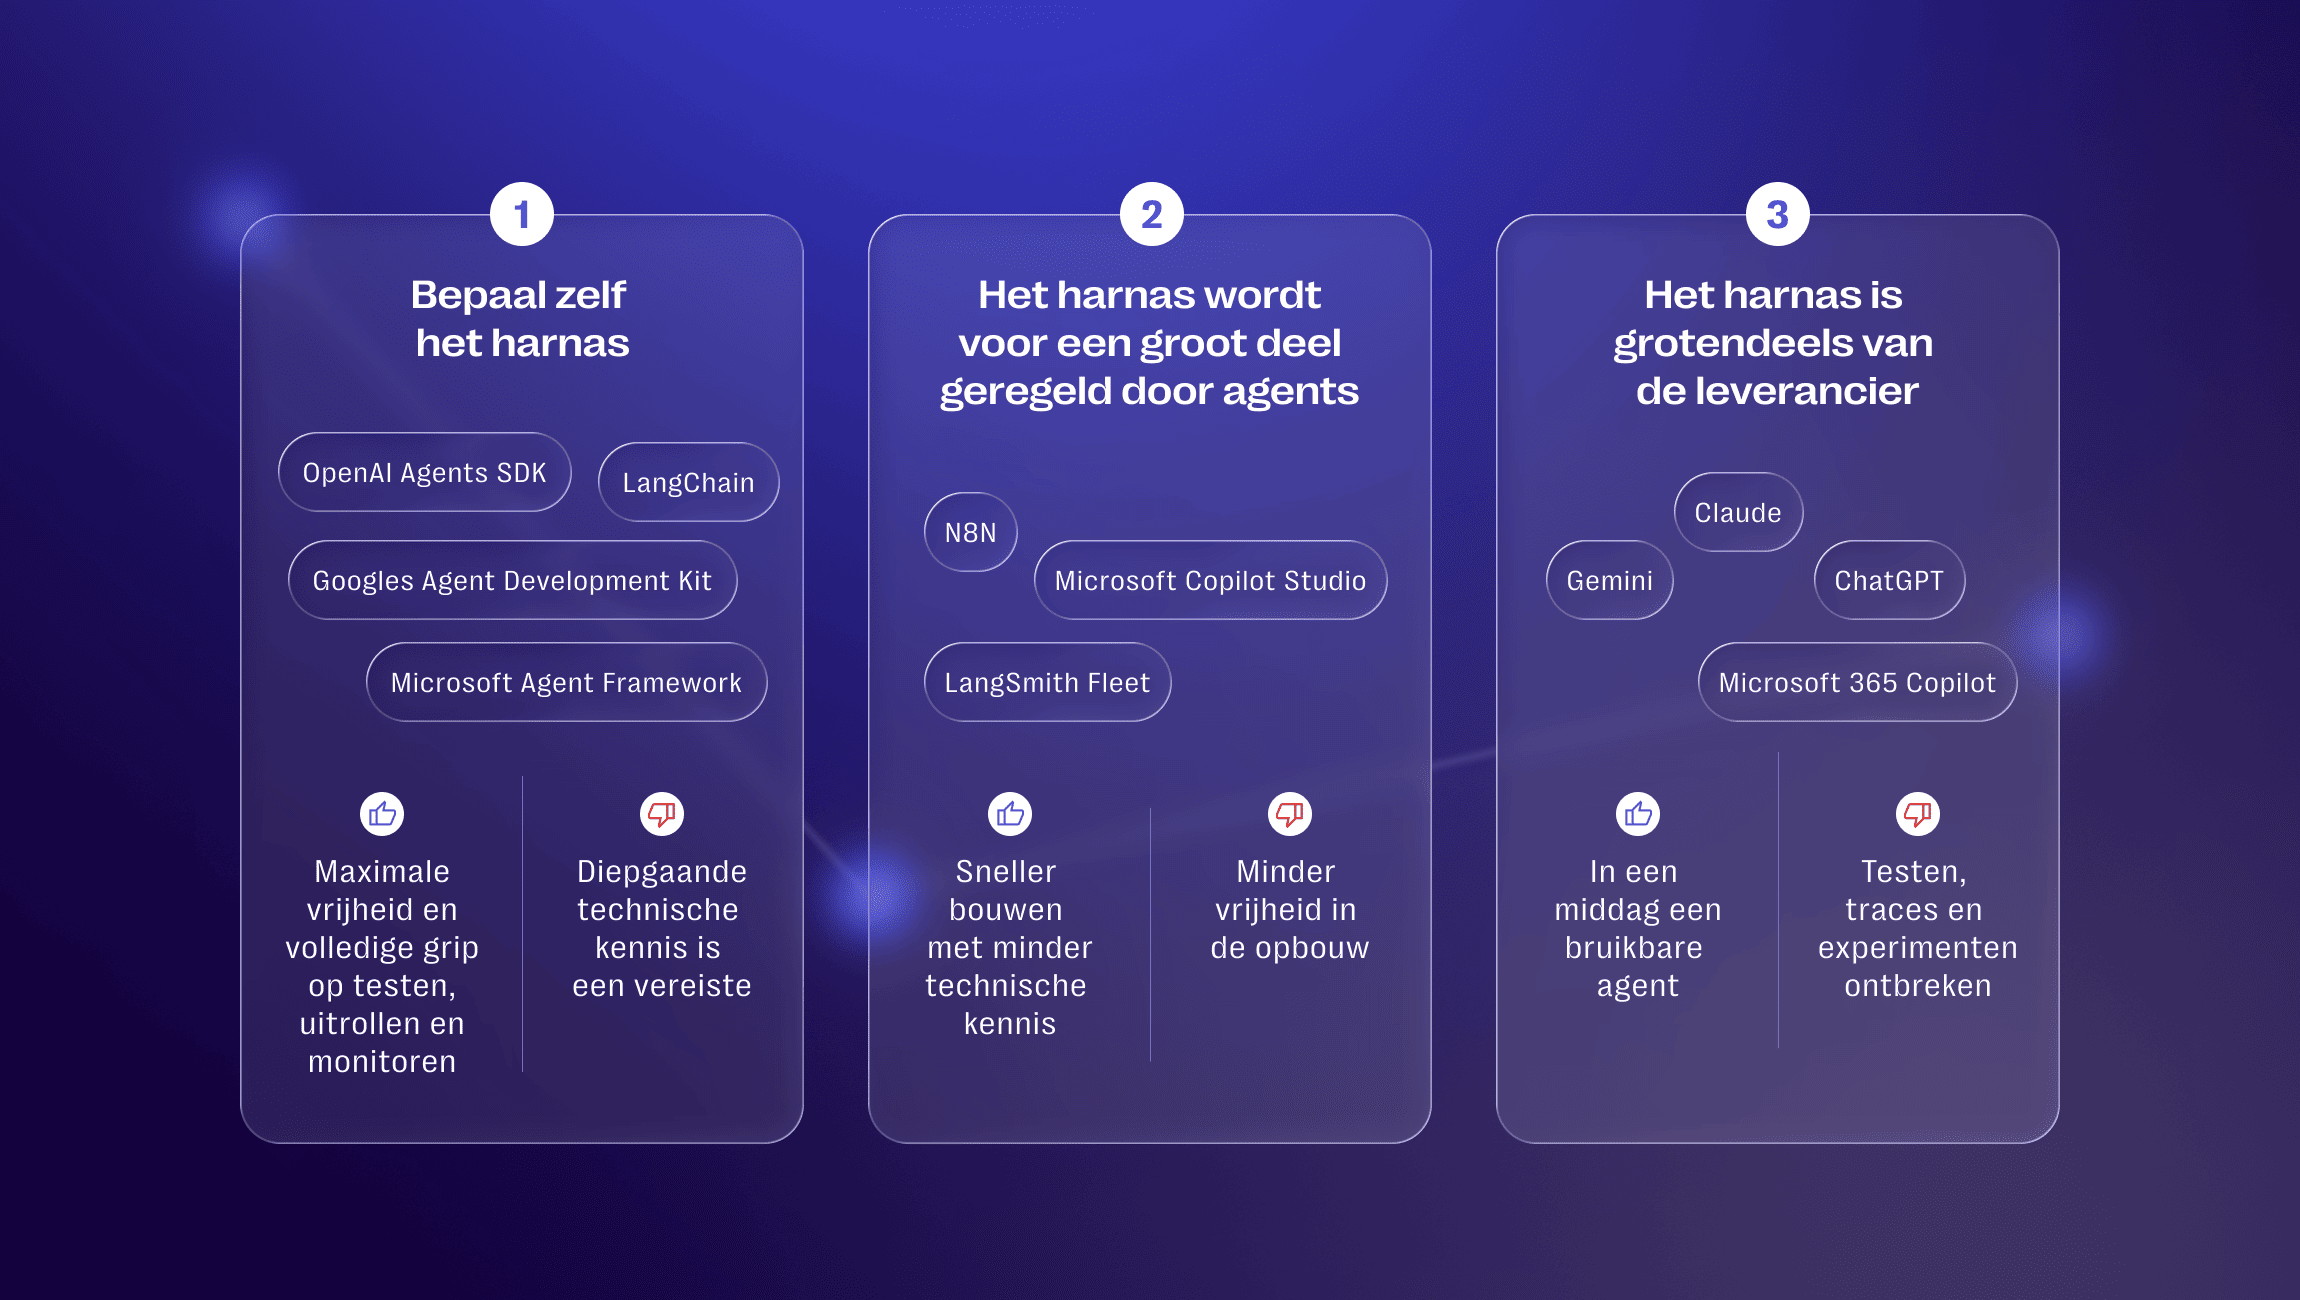
Hoe bouw je een agent? Grofweg zijn er drie routes. Waarvan elke route voornamelijk verschilt in hoeveel van de ADLC je zelf in handen hebt.
Met frameworks als LangChain, de OpenAI Agents SDK, Googles Agent Development Kit of Microsoft Agent Framework bepaal je elk onderdeel van het harnas zelf. Je hebt maximale vrijheid en volledige grip op testen, uitrollen en monitoren. Daar staat tegenover dat je diepgaande technische kennis een vereiste is, dus je hebt AI-engineers nodig om via deze route je agents te bouwen en onderhouden.
Platformen als N8N, Microsoft Copilot Studio of LangSmith Fleet regelen een groot deel van het harnas voor je. Je bouwt sneller en met minder technische kennis, en levert daarvoor wat vrijheid in. Hoeveel vrijheid, dat verschilt flink. N8N kun je zelf hosten en koppelen aan je eigen tracing. Copilot Studio is juist diep verweven met Microsoft 365 en sterk in beheer. Evals hebben ze inmiddels allemaal, maar waar de één losse testvragen toetst, draait de andere complete experimenten. De vraag is dus niet of een platform kan testen, maar hoeveel van de ADLC je er werkelijk mee oppakt.
In Claude, ChatGPT, Gemini of Microsoft 365 Copilot zet een niet-technische collega met instructies, kennis en koppelingen in een middag een bruikbare agent neer. Dat is krachtig om waarde te bewijzen. Maar het harnas is grotendeels van de leverancier, en testen, traces en experimenten ontbreken. Je kunt bouwen, maar de ADLC niet rondmaken.
Geen van die routes is per definitie de beste, het zijn eerder stappen in een groeipad. Begin waar je snel waarde ziet, en schuif op naarmate een agent belangrijker wordt voor je organisatie. Wat wel telt, is dat je weet wat je inlevert. Dat platformen komen en gaan, bleek dit jaar nog. OpenAI kondigde in juni aan te stoppen met Agent Builder en de bijbehorende Evals, nog geen jaar na de lancering (Aankondiging). Wie de instructies, testsets en kennis in eigen beheer had, kon het overzetten. Wie alles in dit platform had gebouwd, moest grotendeels opnieuw beginnen.
Van één agent naar tien
Voor één agent kan dit proces licht blijven. Bij tien agents wordt het een andere vraag. Wat kosten ze samen en welke agent jaagt die kosten op? Welke agent mag welk tool gebruiken, namens wie en kun je achteraf zien wat de agent deed? En als één team een goede skill heeft gebouwd, vindt een ander team dat dan of bouwen zij hetzelfde opnieuw?
Daarom ligt governance om de hele cirkel heen. Niet als vertrager, maar als fundament. Wie kosten, toegang en hergebruik één keer goed regelt, geeft elk volgend team een vliegende start.
Een agent opleveren is een moment. De ADLC draaiende houden is het vak.